Un pedido llega en PDF, otro en Excel: cómo unificar su entrada con IA
Cómo convertir pedidos recibidos en PDF, Excel y correo a un esquema común, conservar su origen y tratar las excepciones antes del ERP.
 Por 10 min de lectura
El mismo cliente puede mandar una hoja de cálculo en enero, un PDF exportado por su sistema en marzo y una modificación escrita en el cuerpo de un correo en abril. Si cada formato tiene un procedimiento diferente, administración acaba haciendo de traductor entre el cliente y el ERP.
Unificar la entrada significa convertir esas fuentes a un esquema de pedido común sin perder lo que decía cada una. La interpretación puede apoyarse en IA, pero el esquema y las reglas de validación son decisiones de negocio. La guía de pedidos por email al ERP aborda el recorrido completo y la confirmación del alta. Aquí nos concentramos en la etapa en la que nacen los datos estructurados.
El esquema común no tiene que copiar ningún archivo
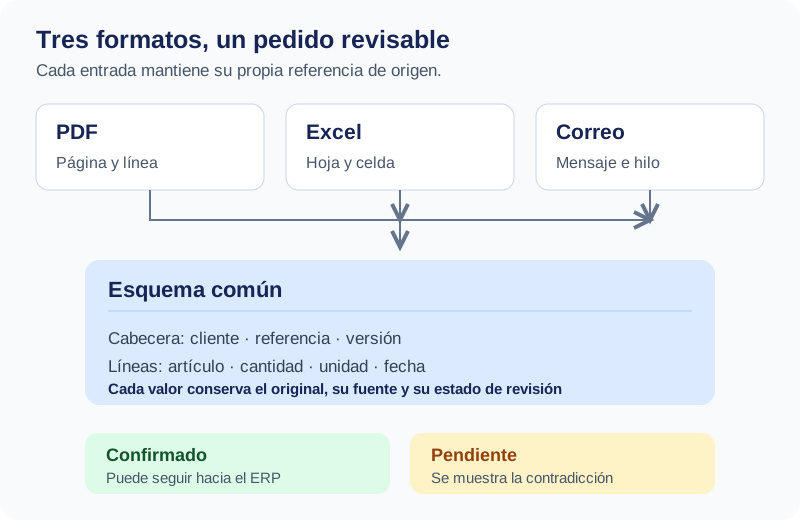
Un formato interno útil separa cabecera, líneas y contexto. En la cabecera van cliente, entidad, referencia externa, versión y destino. Cada línea conserva referencia del cliente, referencia interna si se conoce, descripción, cantidad, unidad, precio indicado y fecha solicitada. El contexto guarda de dónde salió cada dato: correo, archivo, hoja, página o celda.
También necesita un estado por campo. «Ausente», «extraído», «calculado», «corregido por persona» y «validado contra catálogo» no son sinónimos. Esa distinción evita presentar una inferencia como si estuviera escrita en el pedido.
| Entrada original | Dato estructurado | Evidencia que se conserva |
|---|---|---|
Celda C14 de un Excel |
Cantidad: 24 cajas | Archivo, hoja, celda y versión |
| Línea de PDF escaneado | Referencia cliente: AB-21 |
Archivo, página y recorte de origen |
| Frase en correo | «Entrega solicitada en octubre» | Mensaje y texto, marcado como fecha no concreta |
El ejemplo es hipotético. Muestra por qué «octubre» no puede convertirse automáticamente en el día 1 sin inventar precisión.
Elegir la lectura según la entrada
Un Excel con columnas estables puede importarse con reglas. Si el cliente cambia nombres de columnas o intercala notas, hace falta detectar el esquema antes de mapearlo. Un PDF digital permite extraer texto y tablas. Un escaneo requiere OCR. En textos libres, un modelo puede reconocer que una frase modifica una línea anterior.
Microsoft Document Intelligence distingue modelos de clasificación y extracción de campos. Esa separación permite identificar primero qué documento ha llegado y aplicar después el extractor adecuado. En cualquier caso, el sistema debe poder decir «no sé dónde está la cantidad».
No conviene usar un único prompt para hacer todo y escribir directamente en el ERP. Separar etapas permite detectar si el problema está en la lectura, en la asociación al cliente, en el catálogo o en las reglas comerciales.
Referencias, unidades y filas difíciles
La misma pieza puede tener un código del cliente y otro interno. El mapeo necesita una tabla aprobada y un proceso para nuevos artículos. La similitud textual sirve para proponer candidatos cuando no hay coincidencia exacta. Si hay dos posibles, la línea queda pendiente.
También hay que distinguir piezas, cajas, palés y juegos. «20» sin unidad puede ser insuficiente. Un factor de conversión debe venir del catálogo o de una regla verificada, no de una suposición del modelo. Si un PDF agrupa tres referencias en una descripción de kit, el equipo decide si el ERP recibe un kit o sus componentes.
Los encabezados repetidos en cada página, subtotales y líneas de portes son errores comunes de lectura. El conjunto de prueba debe incluirlos. Una tabla que suma el subtotal como si fuera un artículo puede parecer coherente hasta que llegue al pedido.
Versiones y mensajes posteriores
El esquema común debe representar cambios. Si llega «en la línea 4, donde dice 20, deben ser 30», la automatización necesita vincular el mensaje a la versión correcta y proponer la modificación. Si no puede identificar la línea, solicita aclaración. No debe crear un pedido adicional ni corregir la primera línea que contenga un 20.
Cada revisión guarda diferencias respecto a la anterior. El operador puede aprobar el cambio y, si ya se creó el pedido, aplicar el procedimiento comercial que corresponda. Tener una estructura común facilita esa comparación, pero no convierte automáticamente una modificación del cliente en una modificación aceptada.
Fijar precedencias cuando el correo y el adjunto difieren
Un mensaje puede decir «las cantidades buenas son las del Excel» mientras el PDF adjunto lleva otras. Otra vez puede decir «seguimos con los precios del acuerdo anterior» y el archivo incluir un importe diferente. No hay una precedencia técnica universal entre cuerpo, adjunto y dato maestro: el equipo debe fijarla por cliente o tipo de documento, y resolver las contradicciones explícitamente.
El esquema de entrada debería representar dos valores en conflicto, no sobrescribir uno. Por ejemplo, «cantidad del PDF: 40. Cantidad del correo: 60. Resolución pendiente». Si una persona decide que prevalece el correo, se registra su decisión y el documento que se enviará al ERP. Así un auditor o un compañero puede reconstruir por qué la orden final contiene 60.
La normalización también debe conservar idioma, separador decimal y moneda cuando importan. «1.200» puede significar mil doscientos o uno coma dos según el formato. Si la extracción no puede determinarlo por contexto fiable, la línea queda pendiente. Un sistema que procesa muchos documentos no gana nada si convierte una duda en una cantidad falsa.
Diseñar un esquema que soporte la realidad del pedido
La cabecera y las líneas habituales son solo el comienzo. Un pedido puede tener direcciones de entrega por línea, una fecha para cada lote o instrucciones que afectan a toda la orden. Si el esquema común no permite esas relaciones, la extracción tendrá que comprimirlas en una nota y el ERP recibirá datos incompletos. Antes de construirlo, revisaría varios pedidos reales y preguntaría al equipo qué decisiones toma a partir de cada sección.
Un esquema práctico diferencia valor original, valor normalizado y estado de validación. Si un cliente escribe «2 palés» y el catálogo indica 48 cajas por palé, el original sigue siendo «2 palés». La normalización a 96 cajas solo puede mostrarse si ese factor aplica a la referencia y fecha. Un cambio futuro del embalaje no debe alterar retrospectivamente el pedido antiguo.
También separaría identidad de documento e identidad de pedido. Un correo puede traer dos órdenes. Una orden puede llegar en tres archivos y recibir una corrección posterior. El modelo documental debe permitir esas relaciones, no imponer «un adjunto = un pedido». Las referencias externas ayudan, pero su calidad varía entre clientes. Cuando no haya una clave fiable, una persona resuelve la asociación antes del ERP.
Los campos no utilizados también importan. Si una nota dice «mantener embalaje anterior», no conviene descartarla por no encajar en las columnas iniciales. Puede registrarse como instrucción pendiente de clasificar y mostrarla al operador. La unificación no debe borrar información relevante para hacer que el pedido parezca limpio.
Comparar tres caminos técnicos
En un cliente que siempre envía Excel con la misma plantilla, un importador de columnas y validaciones es suficiente. Es barato de explicar y probar. Si las columnas cambian pero los archivos siguen siendo hojas de cálculo, puede añadirse una capa de reconocimiento del esquema y una revisión de casos nuevos. Si llegan PDFs, escaneos y texto libre, la extracción documental y la interpretación con IA pueden ahorrar más trabajo.
Estos caminos pueden convivir. No hay razón para pasar el Excel estable por un modelo generativo si una regla produce el mismo resultado con menos incertidumbre. El sistema puede clasificar primero la entrada y elegir el tratamiento adecuado. La documentación de Microsoft sobre extracción documental muestra capacidades para campos y tablas. El mapeo al catálogo y la gestión de versiones siguen siendo trabajo propio del flujo.
Un problema frecuente es la tabla que continúa en otra página o un archivo con subtotal entre líneas. El extractor debe reconocer qué filas son artículos y cuáles son encabezados, notas o totales. La validación posterior puede comparar suma de líneas con total si ambos están presentes, pero no debe fabricar una línea de ajuste para forzar la igualdad. La diferencia se muestra al revisor.
La elección entre herramientas se prueba con la misma colección de pedidos, no con demostraciones diferentes. Conviene medir cuántas líneas salen correctamente, cuántas quedan pendientes y cuánto tarda una persona en corregirlas. Un modelo que extrae más campos pero genera errores difíciles de detectar puede ser peor que una importación parcial y transparente.
Un recorrido de ejemplo con formatos mezclados
Imaginemos un pedido ficticio PO-418. Llega un PDF con dos líneas y un correo que pide adelantar la primera. El sistema extrae las líneas, conserva la fecha original de cada una y añade la petición del correo como cambio propuesto. Al día siguiente, el cliente envía un Excel con tres líneas y el mismo número de pedido. La herramienta no asume automáticamente que el Excel reemplaza todo: compara referencias, cantidades y fechas, y presenta si la tercera línea es nueva y si las otras dos cambiaron.
En la vista de revisión, el operador debería ver un pequeño historial: PDF inicial, instrucción por correo, Excel posterior. Para cada línea, muestra valor actual propuesto y procedencia. Si la instrucción de adelantar la primera línea sigue vigente, no se pierde al recibir el Excel. Si el Excel trae una fecha nueva, se abre una discrepancia. El equipo decide qué versión representa la voluntad final del cliente.
El ejemplo revela una diferencia entre unificar formatos y resolver intención. Lo primero crea un lenguaje común de campos. Lo segundo determina cómo se combinan mensajes y versiones. La IA puede ayudar a detectar que un correo modifica una línea, pero hace falta un procedimiento comercial para aceptar cambios y pedir confirmación cuando las fuentes no coinciden.
Mantener trazabilidad sin convertirla en trabajo extra
Pedir al operador que copie manualmente una referencia de página en cada corrección eliminaría buena parte del ahorro. La interfaz debe capturar automáticamente archivo, hoja, página o celda de los datos extraídos. Cuando una persona cambia un valor, registra el valor anterior y el motivo de manera ligera. Las correcciones repetitivas pueden convertirse en reglas aprobadas para ese cliente.
La salida hacia el ERP debería usar un esquema validado y versionado. Si la aplicación cambia cómo representa unidades o fechas, los pedidos antiguos deben seguir siendo interpretables. En un piloto no hace falta construir una plataforma universal, pero sí evitar que las versiones del esquema se mezclen sin control.
El seguimiento de errores también debe distinguir lectura de transformación. «20» leído correctamente pero convertido con la unidad equivocada exige corregir el catálogo o la regla. Si se lee «20» como «200», hay que mejorar la extracción o la revisión. Esa separación indica dónde invertir y evita culpar al modelo de fallos de datos maestros.
Cómo evaluar la unificación
Reuniría documentos de varios clientes, tanto habituales como inusuales. Para cada uno prepararía un resultado correcto campo por campo, con estados pendientes donde falte información. La prueba incluiría hojas con fórmulas, PDFs rotados, correos con instrucciones contradictorias y referencias no conocidas.
Mediría exactitud por campo crítico y por línea, no solo por documento. Un encabezado bien leído no compensa una cantidad errónea. También mediría minutos que tarda una persona en resolver cada excepción. El objetivo es producir una propuesta de pedido que se revise más rápido que el original y mantenga sus fuentes a un clic.
Para evaluar cambios de versión, incluiría pedidos cuyo segundo archivo solo corrige una línea y otros cuyo segundo archivo reemplaza todo el contenido. El resultado correcto debe dejar claro qué versión queda vigente, qué instrucciones anteriores persisten y qué diferencias necesitan confirmación. Si no se acuerda esto antes, cualquier automatización parecerá fallar de forma imprevisible.
También revisaría la experiencia del operador. Una pantalla que obliga a abrir el PDF por cada línea quizá tenga buena extracción, pero no ahorra tiempo. La persona necesita ver solo los campos críticos y las dudas, con acceso rápido al original. Las decisiones de interfaz forman parte del rendimiento del proceso, no son una capa cosmética posterior.
Como criterio de aceptación, ninguna cantidad debería entrar en el ERP sin unidad identificada y ninguna corrección por correo debería aplicarse sin vincularla a una versión concreta del pedido. Son condiciones fáciles de comprobar en casos de prueba. Si la herramienta no puede cumplirlas, puede seguir preparando borradores, pero todavía no debería automatizar el alta.
Preguntas frecuentes
¿Hay que usar IA para leer un Excel de pedidos?
No necesariamente. Si las columnas son estables, un mapeo y reglas de validación suelen bastar. La IA ayuda cuando los formatos cambian o la información aparece en texto libre.
¿Qué hacer con una línea incompleta?
Conservar la línea como pendiente, mostrar qué falta y solicitar aclaración. No completar cantidades o referencias por semejanza sin un control acordado.
Sigue leyendo
 Gabriel Martínez Rodríguez
Del email del cliente al ERP: qué automatizar y qué validar antes de crear un pedido
Cómo pasar pedidos de clientes recibidos por correo al ERP con IA, reglas y revisión: referencias, precios, duplicados y confirmación de alta.
Certificados caducados y documentos pendientes: un flujo de seguimiento para compras
Cómo seguir certificados caducados y documentos pendientes de proveedores, preparar solicitudes claras y evitar que las renovaciones se pierdan en el correo.
Cómo revisar certificados y documentos de proveedores con IA antes de homologarlos
Cómo organizar la revisión de certificados de proveedores con IA, controlar vigencias y preparar una homologación trazable sin delegar la aprobación.
¿Por dónde empezaríais en vuestra planta?
Cuéntanos qué proceso os consume más horas y te decimos, sin compromiso, qué automatizaríamos primero y qué haría falta para hacerlo en 90 días.